偶然在網路上看到的影片:用動畫展示氣泡排序法(Bubble Sort)跟快速排序法(Quicksort)的運作原理,並比較兩者的效率(進行比較的次數)。整支影片看起來還滿可愛的。
Visualization of Quick sort
7月 23, 2010

4月 11, 2010
【演算】插入排序法 - Insertion Sort
@
| 標籤:
演算
插入排序法(insertion sort)與選擇排序法(selection sort)類似,同為較簡易、直觀的排序演算法(sorting algorithm)。其原理都是將資料分為「已排序」與「未排序」兩個部份。再將未排序資料中的第一筆資料插入到已排序資料的適當位置。
與選擇排序法相同,一般我們習慣將「已排序」的資料擺在資料序列的前端,並將「未排序」的資料擺在資料序列的後端。
若是我們需要將資料由小排到大。則我們會依序取出每個「未排序」的資料,然後由「已排序」資料的最後一筆開始,往前依序尋找第一個比這筆「未排序」資料還小的元素,並將其後的所有資料往後移一格,再將這筆「未排序」資料「插入」在這個「空出來的位子」。
其虛擬碼如下:
讓我們看看實際操作的例子。若是我們需要將以下資料由小排到大:
則每一次迴圈的執行結果如下:
同樣的,我們必須要分析這種演算法的執行效率如何。
在資料都已排序的最佳情況下,資料大小為 n 的敘述執行次數如下:
敘述的執行次數總和:B(n) = 1 + 1 + (n - 1) + (n - 1) + (n - 1) + (n - 1) + (n - 1) = 5n - 3 ∈ Ο(n)。複雜度為線性時間。
但是在資料完全反序的最差情況(註1):
敘述的執行次數總和:W(n) = 1 + 1 + (n - 1) + (n - 1) + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 + (n - 1) = (3n2 + 3n - 4) / 2 ∈ Ο(n2),複雜度為平方時間。
平均來說,這種演算法的執行效率並不算高,因此也比較不適合用以處理數量較多的資料。
與選擇排序法相同,一般我們習慣將「已排序」的資料擺在資料序列的前端,並將「未排序」的資料擺在資料序列的後端。
若是我們需要將資料由小排到大。則我們會依序取出每個「未排序」的資料,然後由「已排序」資料的最後一筆開始,往前依序尋找第一個比這筆「未排序」資料還小的元素,並將其後的所有資料往後移一格,再將這筆「未排序」資料「插入」在這個「空出來的位子」。
其虛擬碼如下:
Function insertionSort(Type data[1..n])
    Index i, j;
    Type value;
    For i from 2 to n do
        value = data[i];

        j = i - 1;
        While j >= 1 and data[j] > value do
            data[j + 1] = data[j];
            j = j - 1;

        data[j + 1] = value;
End
讓我們看看實際操作的例子。若是我們需要將以下資料由小排到大:
83 31 96 17 42 14 54
則每一次迴圈的執行結果如下:
83 31 96 17 42 14 54
31 83 96 17 42 14 54
31 83 96 17 42 14 54
17 31 83 96 42 14 54
17 31 42 83 96 14 54
14 17 31 42 83 96 54
14 17 31 42 54 83 96
同樣的,我們必須要分析這種演算法的執行效率如何。
在資料都已排序的最佳情況下,資料大小為 n 的敘述執行次數如下:
Function insertionSort(Type data[1..n])
    Index i, j;                                     // 1
    Type value;                                     // 1
    For i from 2 to n do                            // n - 1
        value = data[i];                            // n - 1

        j = i - 1;                                  // n - 1
        While j >= 1 and data[j] > value do         // n - 1
            data[j + 1] = data[j];                  // 0
            j = j - 1;                              // 0

        data[j + 1] = value;                        // n - 1
End
敘述的執行次數總和:B(n) = 1 + 1 + (n - 1) + (n - 1) + (n - 1) + (n - 1) + (n - 1) = 5n - 3 ∈ Ο(n)。複雜度為線性時間。
但是在資料完全反序的最差情況(註1):
Function insertionSort(Type data[1..n])
    Index i, j;                                     // 1
    Type value;                                     // 1
    For i from 2 to n do                            // n - 1
        value = data[i];                            // n - 1

        j = i - 1;                                  // n - 1
        While j >= 1 and data[j] > value do         // n(n - 1) / 2
            data[j + 1] = data[j];                  // n(n - 1) / 2
            j = j - 1;                              // n(n - 1) / 2

        data[j + 1] = value;                        // n - 1
End
敘述的執行次數總和:W(n) = 1 + 1 + (n - 1) + (n - 1) + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 + (n - 1) = (3n2 + 3n - 4) / 2 ∈ Ο(n2),複雜度為平方時間。
平均來說,這種演算法的執行效率並不算高,因此也比較不適合用以處理數量較多的資料。
註1. 其中的 n(n - 1) / 2 是由 (n - 1) + (n - 2) + (n - 3) + ... + 1 加總化簡而來。
4月 10, 2010
【演算】合併排序法 - Mergesort
@
| 標籤:
演算
合併排序法(mergesort)是一個典型利用分治法(divide and conquer,D&C)解決問題的例子。其原理為不斷地將資料分成兩等分,直到每份的資料量小到一個程度後,各自排序後再一一合併起來。
假設現在有 n 筆資料需要進行排序。
則我們首先會將這 n 筆資料分成兩等分(大小皆為 n/2);接著,再將這兩堆大小為 n/2 的資料各自分為兩等分(大小皆為 n/4);同樣的,我們再將這四堆大小為 n/4 的資料各自分為兩等分(大小皆為 n/8)。
如此進行下去,直到每堆的資料量足夠小(例如:每堆只剩 1 筆資料)之後,我們就分別將每堆資料進行排序,再將這些資料堆兩兩一對進行合併,直到排序完成為止。

其虛擬碼大致如下:
讓我們舉個實際的例子說明:現在我們有八筆資料需要排序(由小而大):
且只要每堆的資料量大於 1 時,就需要再將資料進行分割。
首先,我們先將資料分成兩等分:
此時每堆的資料量為 4 (8 / 2) > 1。因此,我們還需要將每堆資料再各自分成兩等分:
此時每堆的資料量為 2 (4 / 2) > 1。再一次,我們將每堆資料各自分成兩等分:
此時每堆的資料量為 1 (2 / 2) = 1 ,符合停止切割的條件。所以接下來,我們要將資料兩兩合併。在合併的同時,同時確保資料排序:
同樣的,我們將資料兩兩合併:
同樣的,我們將資料兩兩合併:
最後,我們從時間效率上來討論合併排序法。設 merge sort 的時間複雜度函數為 T(n)。
我們可以知道,在每一次呼叫 mergeSort() 函式時,我們都需要分別將前半段與後半段的資料複製給 left 跟 right,所以複製資料的時間花費為 c1n。
然後,我們需要遞迴呼叫兩次資料大小為 n/2 的 mergeSort(),時間花費為 2T(n / 2)。最後再加上呼叫 merge() 函式所需的時間花費 c2n。所以我們可以得到:T(n) = 2T(n / 2) + cn (n > 1),且 T(1) = 1。
若是將式子展開:T(n) = 2T(n / 2) + cn = 4T(n / 4) + 2c(n / 2) + cn = 8T(n / 8) + 4c(n / 4) + 2c(n / 2) + cn = ... = cn + cn + cn + ... + cn = cn(lg n + 1) ∈ O(n lg n)(註1)。
由此可見,合併排序的的時間效率是相當不錯的。
另外,因為有網友詢問非遞迴的合併排序法,因此試著寫了以下這個虛擬碼:
寫起來感覺不太直觀,如果有錯誤歡迎糾正我:)
註1. 其實可以直接利用支配定理(Master theorem)來求出複雜度 T(n)。
假設現在有 n 筆資料需要進行排序。
則我們首先會將這 n 筆資料分成兩等分(大小皆為 n/2);接著,再將這兩堆大小為 n/2 的資料各自分為兩等分(大小皆為 n/4);同樣的,我們再將這四堆大小為 n/4 的資料各自分為兩等分(大小皆為 n/8)。
如此進行下去,直到每堆的資料量足夠小(例如:每堆只剩 1 筆資料)之後,我們就分別將每堆資料進行排序,再將這些資料堆兩兩一對進行合併,直到排序完成為止。

其虛擬碼大致如下:
Function mergeSort(Type data[1..n])
    If n <= 1 then return

    Index x, y, i, j
    x = n / 2
    y = n - x

    Type left[1..x], right[1..y]
    For i from 1 to x do
        left[i] = data[i]
    For i from 1 to y do
        right[i] = data[x + i]

    mergeSort(left)
    mergeSort(right)
    merge(data, left, right)
End

Function merge(Type data[1..n], Type left[1..x], Type right[1..y])
    Index i, j, k
    i = j = k = 1

    While i <= x and j <= y do
        If left[i] < right[j] then
            data[k] = left[i]
            i = i + 1
        Else
            data[k] = right[j]
            j = j + 1
        k = k + 1

    While i <= x do
        data[k] = left[i]
        i = i + 1
        k = k + 1

    While j <= y do
        data[k] = right[j]
        j = j + 1
        k = k + 1
End
讓我們舉個實際的例子說明:現在我們有八筆資料需要排序(由小而大):
(84、13、73、26、32、19、91、38)
且只要每堆的資料量大於 1 時,就需要再將資料進行分割。
首先,我們先將資料分成兩等分:
(84、13、73、26) (32、19、91、38)
此時每堆的資料量為 4 (8 / 2) > 1。因此,我們還需要將每堆資料再各自分成兩等分:
(84、13) (73、26) (32、19) (91、38)
此時每堆的資料量為 2 (4 / 2) > 1。再一次,我們將每堆資料各自分成兩等分:
(13) (84) (26) (73) (19) (32) (38) (91)
此時每堆的資料量為 1 (2 / 2) = 1 ,符合停止切割的條件。所以接下來,我們要將資料兩兩合併。在合併的同時,同時確保資料排序:
(13、84) (26、73) (19、32) (38、91)
同樣的,我們將資料兩兩合併:
(13、26、73、84) (19、32、38、91)
同樣的,我們將資料兩兩合併:
(13、19、26、32、38、73、84、91)
最後,我們從時間效率上來討論合併排序法。設 merge sort 的時間複雜度函數為 T(n)。
我們可以知道,在每一次呼叫 mergeSort() 函式時,我們都需要分別將前半段與後半段的資料複製給 left 跟 right,所以複製資料的時間花費為 c1n。
然後,我們需要遞迴呼叫兩次資料大小為 n/2 的 mergeSort(),時間花費為 2T(n / 2)。最後再加上呼叫 merge() 函式所需的時間花費 c2n。所以我們可以得到:T(n) = 2T(n / 2) + cn (n > 1),且 T(1) = 1。
若是將式子展開:T(n) = 2T(n / 2) + cn = 4T(n / 4) + 2c(n / 2) + cn = 8T(n / 8) + 4c(n / 4) + 2c(n / 2) + cn = ... = cn + cn + cn + ... + cn = cn(lg n + 1) ∈ O(n lg n)(註1)。
由此可見,合併排序的的時間效率是相當不錯的。
另外,因為有網友詢問非遞迴的合併排序法,因此試著寫了以下這個虛擬碼:
Function mergeSort(Type data[1..n])
    If n <= 1 then return

    Index i, j, k
    For i from 2 to (n / 2) do
        For j from 0 to (n - 1) step (2 * i) do
            Index x, y
            x = min(i, n - j)
            y = min(i, max(0, n - i - j))

            Type left[1..x], right[1..y]
            For k from 1 to x do
                left[k] = data[j + k]
            For k from 1 to y do
                right[k] = data[i + j + k]

            Index p, q, r
            p = q = 1
            r = j
            While p <= x and q <= y do
                If left[p] < right[q] then
                    data[r] = left[p]
                    p = p + 1
                Else
                    data[r] = right[q]
                    q = q + 1
                r = r + 1

            While p <= x do
                data[r] = left[p]
                p = p + 1
                r = r + 1

            While q <= y do
                data[r] = right[q]
                q = q + 1
                r = r + 1
End
寫起來感覺不太直觀,如果有錯誤歡迎糾正我:)
註1. 其實可以直接利用支配定理(Master theorem)來求出複雜度 T(n)。
3月 20, 2010
【演算】選擇排序法 - Selection Sort
@
| 標籤:
演算
選擇排序法(selection sort)為一種較直觀的排序演算法(sorting algorithm)。其將資料分為「已排序」與「未排序」兩部份,並從「未排序」的資料中找出最大(最小)值,放入「已排序」資料的最後端。如是進行,直到排序結束(未排序資料為空)為止。
一般來說,我們的作法是:將「已排序」的資料擺在資料序列的前端,並將「未排序」的資料擺在資料序列的後端。
假設我們需要將 n 筆資料由大排到小。在起初,這 n 筆資料都是「未排序」的。於是,我們從這 n 筆資料取出其中的最大值,並將之放在「已排序」資料的最後端。換言之,就是將之與第一筆資料進行交換。
接著,我們再從剩下的 n - 1 筆資料取出最大值,同樣放入「已排序」資料的最後端(與第二筆資料進行交換);再從剩下的 n - 2 筆資料取出最大值,放入「已排序」資料的最後端(與第三筆資料進行交換)。
以此類推,直到沒有任何「未排序」的資料為止。
選擇排序法的虛擬碼大致如下:
舉例來說,若我們需要將以下資料由大排到小:
則以此演算法運作的過程如下:
若是我們分析在最差情況下(所有資料的順序剛好完全相反),使用選擇排序法將 n 筆資料排序的敘述執行次數(註1):
經由以上,我們可以得到最差情況下,敘訴的執行次數總和:W(n) = 1 + n + n + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 + n = (3n2 + 3n - 2) / 2 ∈ Ο(n2)。
由此可知,選擇排序法的時間複雜度與之前介紹過的氣泡排序法(bubble sort)相當,同樣為效率不大優良的排序演算法。
一般來說,我們的作法是:將「已排序」的資料擺在資料序列的前端,並將「未排序」的資料擺在資料序列的後端。
假設我們需要將 n 筆資料由大排到小。在起初,這 n 筆資料都是「未排序」的。於是,我們從這 n 筆資料取出其中的最大值,並將之放在「已排序」資料的最後端。換言之,就是將之與第一筆資料進行交換。
接著,我們再從剩下的 n - 1 筆資料取出最大值,同樣放入「已排序」資料的最後端(與第二筆資料進行交換);再從剩下的 n - 2 筆資料取出最大值,放入「已排序」資料的最後端(與第三筆資料進行交換)。
以此類推,直到沒有任何「未排序」的資料為止。
選擇排序法的虛擬碼大致如下:
Function selectionSort(Type data[1..n])
    Index i, j, max
    For i from 1 to n do
        max = i
        For j from i + 1 to n do
            If data[j] > data[max] then
                max = j

        Exchange data[i] and data[max]
End
舉例來說,若我們需要將以下資料由大排到小:
19 58 33 41 28 14 53 84
則以此演算法運作的過程如下:
84 58 33 41 28 14 53 19
84 58 33 41 28 14 53 19
84 58 53 41 28 14 33 19
84 58 53 41 28 14 33 19
84 58 53 41 33 14 28 19
84 58 53 41 33 28 14 19
84 58 53 41 33 28 19 14
84 58 53 41 33 28 19 14
若是我們分析在最差情況下(所有資料的順序剛好完全相反),使用選擇排序法將 n 筆資料排序的敘述執行次數(註1):
Function selectionSort(Type data[1..n])
    Index i, j, max                                 // 1
    For i from 1 to n do                            // n
        max = i                                     // n
        For j from i + 1 to n do                    // n(n - 1) / 2
            If data[j] > data[max] then             // n(n - 1) / 2
                max = j                             // n(n - 1) / 2

        Exchange data[i] and data[max]              // n
End
經由以上,我們可以得到最差情況下,敘訴的執行次數總和:W(n) = 1 + n + n + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 + n = (3n2 + 3n - 2) / 2 ∈ Ο(n2)。
由此可知,選擇排序法的時間複雜度與之前介紹過的氣泡排序法(bubble sort)相當,同樣為效率不大優良的排序演算法。
註1. 其中的 n(n - 1) / 2 是由 (n - 1) + (n - 2) + (n - 3) + ... + 1 加總化簡而來。
3月 07, 2010
【演算】氣泡排序法 - Bubble Sort
@
| 標籤:
演算
氣泡排序法(bubble sort)是排序演算法(sorting algorithm)中較簡易的一種。其運作的原理是藉由逐次比較相鄰的兩筆資料,並依照排序條件(由大至小或由小至大)交換資料直到排序完成為止。
假設現在我們需要將 n 筆資料 A1、A2、......、An 由小排到大。
一開始,我們需要先比較 A1 與 A2 兩筆資料的大小。若是 A1 > A2,則交換兩筆資料;接著比較 A2 與 A3。若是 A2 > A3,則交換兩筆資料;以此類推,一直到比較完 An - 1 與 An 為止。
這樣就完了嗎?當然還沒。到目前為止,我們只確定 An 是 n 筆資料中最大的數字。
接下來,重複剛剛的動作:比較 A1 與 A2、A2 與 A3、A3 與 A4、......,不同的是,這一次只需要比較到 An - 2 與 An - 1 即可。到目前為止,我們可以確定 An - 1 是 n 筆資料中次大的數字。
接著就繼續重複同樣的動作,便能確定每一輪比較中的最大資料,皆在這些資料的最後面。直到所有資料排序完成為止。
其原理的虛擬碼大致如下:
讓我們舉個實際的例子來說明。若是我們現在要將以下這些資料由大排到小:
則第一輪的比較與交換過程如下:
第二輪的比較與交換過程如下:
接下來以此類推。
由此可以看到,資料中較小的一筆會藉由交換慢慢「浮」到資料頂端,其「氣泡排序」之名也是因此而來。
若是我們分析在最差情況下(即所有資料的順序剛好完全相反,因為我們必須在每一輪迴圈,藉由不斷交換兩筆資料的動作,把最前頭的資料移到最後面),使用氣泡排序法將 n 筆資料排序的敘述執行次數(註1):
可得出所有敘述的執行次數總和為:W(n) = 1 + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 = (3n2 - n) / 2 ∈ Ο(n2),為一個平方時間(quadratic time)的演算法。
而在最好的情況下(即所有資料都為已排序狀態,因為不需要進行任何一次交換動作):
所有敘述的執行次數總和為:B(n) = 1 + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + 0 = n2 ∈ Ο(n2)。複雜度依舊為平方時間。
對於一種排序演算法而言,這樣複雜度是相當沒有效率的。因此這個方法多半只是被拿來簡單的解釋排序概念,而不是拿來實際應用。
假設現在我們需要將 n 筆資料 A1、A2、......、An 由小排到大。
一開始,我們需要先比較 A1 與 A2 兩筆資料的大小。若是 A1 > A2,則交換兩筆資料;接著比較 A2 與 A3。若是 A2 > A3,則交換兩筆資料;以此類推,一直到比較完 An - 1 與 An 為止。
這樣就完了嗎?當然還沒。到目前為止,我們只確定 An 是 n 筆資料中最大的數字。
接下來,重複剛剛的動作:比較 A1 與 A2、A2 與 A3、A3 與 A4、......,不同的是,這一次只需要比較到 An - 2 與 An - 1 即可。到目前為止,我們可以確定 An - 1 是 n 筆資料中次大的數字。
接著就繼續重複同樣的動作,便能確定每一輪比較中的最大資料,皆在這些資料的最後面。直到所有資料排序完成為止。
其原理的虛擬碼大致如下:
Function bubbleSort(Type data[1..n])
    Index i, j;
    For i from n to 2 do
        For j from 1 to i - 1 do
            If data[j] > data[j + 1] then
                Exchange data[j] and data[j + 1]
End
讓我們舉個實際的例子來說明。若是我們現在要將以下這些資料由大排到小:
1 43 6 79 50 2
則第一輪的比較與交換過程如下:
43 1 6 79 50 2
43 6 1 79 50 2
43 6 79 1 50 2
43 6 79 50 1 2
43 6 79 50 2 1
第二輪的比較與交換過程如下:
43 6 79 50 2 1
43 79 6 50 2 1
43 79 50 6 2 1
43 79 50 6 2 1
接下來以此類推。
由此可以看到,資料中較小的一筆會藉由交換慢慢「浮」到資料頂端,其「氣泡排序」之名也是因此而來。
若是我們分析在最差情況下(即所有資料的順序剛好完全相反,因為我們必須在每一輪迴圈,藉由不斷交換兩筆資料的動作,把最前頭的資料移到最後面),使用氣泡排序法將 n 筆資料排序的敘述執行次數(註1):
Function bubbleSort(Type data[1..n])
    Index i, j;                                     // 1
    For i from n to 2 do                            // n - 1
        For j from 1 to i - 1 do                    // n(n - 1) / 2
            If data[j] > data[j + 1] then           // n(n - 1) / 2
                Exchange data[j] and data[j + 1]    // n(n - 1) / 2
End
可得出所有敘述的執行次數總和為:W(n) = 1 + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + n(n - 1) / 2 = (3n2 - n) / 2 ∈ Ο(n2),為一個平方時間(quadratic time)的演算法。
而在最好的情況下(即所有資料都為已排序狀態,因為不需要進行任何一次交換動作):
Function bubbleSort(Type data[1..n])
    Index i, j;                                     // 1
    For i from n to 2 do                            // n - 1
        For j from 1 to i - 1 do                    // n(n - 1) / 2
            If data[j] > data[j + 1] then           // n(n - 1) / 2
                Exchange data[j] and data[j + 1]    // 0
End
所有敘述的執行次數總和為:B(n) = 1 + (n - 1) + n(n - 1) / 2 + n(n - 1) / 2 + 0 = n2 ∈ Ο(n2)。複雜度依舊為平方時間。
對於一種排序演算法而言,這樣複雜度是相當沒有效率的。因此這個方法多半只是被拿來簡單的解釋排序概念,而不是拿來實際應用。
註1. 其中的 n(n - 1) / 2 是由 (n - 1) + (n - 2) + (n - 3) + ... + 1 加總化簡而來。
【演算】遞迴函式 - Recursive Function
@
| 標籤:
演算
所謂的遞迴(recursion),簡單來說就是「函式(function)不斷呼叫自身」的一種程式撰寫法。遞迴的意義,在於把一個問題切割成相同性質的較小問題來解決。而為了防止程式無窮盡的遞迴下去,我們還必須為所寫出來的遞迴函式設定一個終止條件(termination condition)。
遞迴的原理,是利用函式本身的堆疊(stack)性質--後進先出(last in, first out,LIFO)來達成的。說得簡單一點,就是當某個函式呼叫另一個函式時,其會先執行完被呼叫的函式,才繼續執行自身的函式內容。
讓我們舉一個常見的例子來解釋:階乘(factorial)。
在數學上的定義中,對於一個非負整數 n,其階乘代表的是所有小於或等於 n 的正整數乘積,記作 n!。即 n! = 1 × 2 × 3 × ... × n。若我們規定 0! = 1,則可以將之改寫成:對於所有非負整數 n,(n + 1)! = (n + 1) × n!。
於是,我們便可以利用程式寫出計算階乘的遞迴函式。以下為其虛擬碼:
在這裡,我們相當於將原始的問題 n! 看作是 n × (n - 1)! 這個較小的問題。也就是得知 (n - 1)! 的值,就可以求得 n! 的解。同樣的,又可以將 (n - 1)! 看作是 (n - 1) × (n - 2)!、將 (n - 2)! 看作是 (n - 2) × (n - 3)!、......。
舉例來說,若是我們需要利用程式求出 6! 的值。則在我們呼叫 factorial(6) 時,為了得出結果,亦須求出 factorial(5) 的值。而為了得出 factorial(5) 的結果,我們亦須求出 factorial(4) 的值......。一直不斷遞迴下去,直到達到終止條件:n = 0 為止。
實際運作的結果,就如下圖所示意的(藍箭頭代表呼叫,紅箭頭代表回傳):

除此之外,遞迴還可以解決相當多其他的問題。例如斐波那契數列(fibonacci sequence)、老鼠走迷宮(mouse in a maze)、以及河內塔(tower of hanoi)等等,這裡我就不加贅述了。
雖然利用程式的遞迴解法較為直觀,但是不斷堆疊函式的結果,極有可能浪費了過多的記憶體空間。其實,遞迴的程式多半都能藉由迴圈的方式替代,只是程式也可能會因此變得複雜難懂。至於實際上要使用何者,就看你怎麼選擇囉。
遞迴的原理,是利用函式本身的堆疊(stack)性質--後進先出(last in, first out,LIFO)來達成的。說得簡單一點,就是當某個函式呼叫另一個函式時,其會先執行完被呼叫的函式,才繼續執行自身的函式內容。
讓我們舉一個常見的例子來解釋:階乘(factorial)。
在數學上的定義中,對於一個非負整數 n,其階乘代表的是所有小於或等於 n 的正整數乘積,記作 n!。即 n! = 1 × 2 × 3 × ... × n。若我們規定 0! = 1,則可以將之改寫成:對於所有非負整數 n,(n + 1)! = (n + 1) × n!。
於是,我們便可以利用程式寫出計算階乘的遞迴函式。以下為其虛擬碼:
Function factorial(Integer n)
    If n = 0 then
        Return 1
    Else
        Return n × factorial(n - 1)
End
在這裡,我們相當於將原始的問題 n! 看作是 n × (n - 1)! 這個較小的問題。也就是得知 (n - 1)! 的值,就可以求得 n! 的解。同樣的,又可以將 (n - 1)! 看作是 (n - 1) × (n - 2)!、將 (n - 2)! 看作是 (n - 2) × (n - 3)!、......。
舉例來說,若是我們需要利用程式求出 6! 的值。則在我們呼叫 factorial(6) 時,為了得出結果,亦須求出 factorial(5) 的值。而為了得出 factorial(5) 的結果,我們亦須求出 factorial(4) 的值......。一直不斷遞迴下去,直到達到終止條件:n = 0 為止。
實際運作的結果,就如下圖所示意的(藍箭頭代表呼叫,紅箭頭代表回傳):

除此之外,遞迴還可以解決相當多其他的問題。例如斐波那契數列(fibonacci sequence)、老鼠走迷宮(mouse in a maze)、以及河內塔(tower of hanoi)等等,這裡我就不加贅述了。
雖然利用程式的遞迴解法較為直觀,但是不斷堆疊函式的結果,極有可能浪費了過多的記憶體空間。其實,遞迴的程式多半都能藉由迴圈的方式替代,只是程式也可能會因此變得複雜難懂。至於實際上要使用何者,就看你怎麼選擇囉。
3月 06, 2010
【演算】複雜度分析 - Complexity Analysis
@
| 標籤:
演算
在演算法簡介中,我們提到了「找電話」問題的兩個演算法:分別為「依序找」跟「按筆劃找」。我們可以知道,對於相同的問題,可能會同時存在許多不同的解法。然而在這種擁有多種可能解法的情況下,我們理應對這些演算法進行評估,並從中選擇一種最有效的方式。
從比較執行時間的層面來看,或許你會想到:直接利用計時器來比較不同演算法實現程式的執行時間。但是,這種方式的變因太多。實作演算法的程式語言、記憶體大小、不同的編譯(直譯)器、甚至是電腦中運行的程式,可能都會影響計時所得的結果。相對的,這種方式也就顯得不太準確。
除了實際去計時之外,我們也可以假設演算法中「每一步」的執行時間都相同。於是,我們也可以直接拿演算法所有「步驟」的執行次數總和來進行比較。
讓我們同樣以「依序找電話」演算法為例。
先考慮在最差情況(worst case)下(也就是欲尋找的電話號碼不在電話簿中,因為你必須搜遍整本電話簿),「依序找電話」虛擬碼每行敘述的執行次數如下(方便起見,我們以變數 n 代表電話簿的大小 phoneBook.size):
因此在最差情況下,每行敘述的執行次數總和:W(n) = 1 + n + n + 1 + 1 + n + 0 + 0 + n = 4n + 3。
由此可以發現,一個演算法的執行時間通常會隨著輸入資料的大小 n 的成長而成長(註1)。而這個與資料大小 n 相關的時間(或空間)函數,則稱為這個演算法的複雜度(complexity)。
不過,我們還可以用更簡明、更具數學意義的方式來表達它。
首先,我們可以知道當 n 是一個相當大的數字時,4n 是遠大於 3 的。換句話說,就是我們只需要保留函數的最高項,也就是這個例子中的 4n。而若是只想考慮其函數的成長趨勢,我們甚至可以連其係數一併省略,只注意 n 這個部份,代表這個演算法是一個線性時間(linear time)的演算法,記作 O(n)。
Ο(big-omicron,或是稱作 big-O)是一個漸進符號(asymptotic notation),代表了函數的漸進上限(asymptotic upper bound)。其定義如下:
簡單來說,若是我們說一個演算法的複雜度函數 f(n) ∈ Ο(g(n)),就代表函數 f(n) 的成長趨勢與 g(n) 相似或是更慢的。
除了 big-omicron 之外,我們還可以使用 Ω(big-omega)、Θ(big-theta)、ο(little-omicron)與 ω(little-omega)來表達一個演算法的複雜度。
big-omega 代表了函數的漸進下限(asymptotic lower bound)。簡單來說,若是我們說一個演算法的複雜度函數 f(n) ∈ Ω(g(n)),就代表 f(n) 函數圖形的成長趨勢與 g(n) 相似或是更快的。其正式的定義如下:
那麼 big-theta 呢?其實,big-theta 也就相等於 big-omicron 與 big-omega 的交集,也就是 Θ(g(n)) = Ο(g(n)) ∩ Ω(g(n)),代表 f(n) 函數圖形的成長趨勢與 g(n) 是相似的。其正式的定義如下:
而 little-omicron 與 little-omega 則分別為 big-omicron 與 big-omega 和 big-theta 的差集,即 ο(g(n)) = Ο(g(n)) - Θ(g(n)), ω(g(n)) = Ω(g(n)) - Θ(g(n))。以下為其正式定義:
為了方便比較,我們可以將 f(n) 與 g(n) 比擬成 a 跟 b,則:
雖然存在這麼多種漸進符號以表達演算法的複雜度,但是一般來說,當我們分析一個演算法的複雜度,比較常使用 big-omicron 來表達估算後的結果。這是因為對於一個演算法,其所耗費的時間(或是記憶體)上限,通常才是我們需要關注的重點。
從比較執行時間的層面來看,或許你會想到:直接利用計時器來比較不同演算法實現程式的執行時間。但是,這種方式的變因太多。實作演算法的程式語言、記憶體大小、不同的編譯(直譯)器、甚至是電腦中運行的程式,可能都會影響計時所得的結果。相對的,這種方式也就顯得不太準確。
除了實際去計時之外,我們也可以假設演算法中「每一步」的執行時間都相同。於是,我們也可以直接拿演算法所有「步驟」的執行次數總和來進行比較。
讓我們同樣以「依序找電話」演算法為例。
先考慮在最差情況(worst case)下(也就是欲尋找的電話號碼不在電話簿中,因為你必須搜遍整本電話簿),「依序找電話」虛擬碼每行敘述的執行次數如下(方便起見,我們以變數 n 代表電話簿的大小 phoneBook.size):
Input name                                          // 1
While True do                                       // n
    If index > phoneBook.size then                  // n
        Output "phone number not found"             // 1
        Break loop                                  // 1

    If phoneBook.record[index].name = name then     // n
        Output phoneBook.record[index].phone        // 0
        Break loop                                  // 0

    index = index + 1                               // n
因此在最差情況下,每行敘述的執行次數總和:W(n) = 1 + n + n + 1 + 1 + n + 0 + 0 + n = 4n + 3。
由此可以發現,一個演算法的執行時間通常會隨著輸入資料的大小 n 的成長而成長(註1)。而這個與資料大小 n 相關的時間(或空間)函數,則稱為這個演算法的複雜度(complexity)。
不過,我們還可以用更簡明、更具數學意義的方式來表達它。
首先,我們可以知道當 n 是一個相當大的數字時,4n 是遠大於 3 的。換句話說,就是我們只需要保留函數的最高項,也就是這個例子中的 4n。而若是只想考慮其函數的成長趨勢,我們甚至可以連其係數一併省略,只注意 n 這個部份,代表這個演算法是一個線性時間(linear time)的演算法,記作 O(n)。
Ο(big-omicron,或是稱作 big-O)是一個漸進符號(asymptotic notation),代表了函數的漸進上限(asymptotic upper bound)。其定義如下:
對於兩個非負函數 f(n) 與 g(n),若且唯若存在一正整數 n0 與 c > 0,使得所有整數 n ≥ n0 都滿足 0 ≤ f(n) ≤ cg(n),則 f(n) ∈ Ο(g(n))。
簡單來說,若是我們說一個演算法的複雜度函數 f(n) ∈ Ο(g(n)),就代表函數 f(n) 的成長趨勢與 g(n) 相似或是更慢的。
除了 big-omicron 之外,我們還可以使用 Ω(big-omega)、Θ(big-theta)、ο(little-omicron)與 ω(little-omega)來表達一個演算法的複雜度。
big-omega 代表了函數的漸進下限(asymptotic lower bound)。簡單來說,若是我們說一個演算法的複雜度函數 f(n) ∈ Ω(g(n)),就代表 f(n) 函數圖形的成長趨勢與 g(n) 相似或是更快的。其正式的定義如下:
對於兩個非負函數 f(n) 與 g(n),若且唯若存在一正整數 n0 與 c > 0,使得所有整數 n ≥ n0 都滿足 0 ≤ cg(n) ≤ f(n),則 f(n) ∈ Ω(g(n))。
那麼 big-theta 呢?其實,big-theta 也就相等於 big-omicron 與 big-omega 的交集,也就是 Θ(g(n)) = Ο(g(n)) ∩ Ω(g(n)),代表 f(n) 函數圖形的成長趨勢與 g(n) 是相似的。其正式的定義如下:
對於兩個非負函數 f(n) 與 g(n),若且唯若存在一正整數 n0, c1與 c2 > 0,使得所有整數 n ≥ n0 都滿足 c1g(n) ≤ f(n) ≤ c2g(n),則 f(n) ∈ Θ(g(n))。
而 little-omicron 與 little-omega 則分別為 big-omicron 與 big-omega 和 big-theta 的差集,即 ο(g(n)) = Ο(g(n)) - Θ(g(n)), ω(g(n)) = Ω(g(n)) - Θ(g(n))。以下為其正式定義:
對於兩個非負函數 f(n) 與 g(n),若且唯若存在一正整數 n0 與 c > 0,使得所有整數 n ≥ n0 都滿足 0 ≤ f(n) < cg(n),則 f(n) ∈ ο(g(n))。
對於兩個非負函數 f(n) 與 g(n),若且唯若存在一正整數 n0 與 c > 0,使得所有整數 n ≥ n0 都滿足 0 ≤ cg(n) < f(n),則 f(n) ∈ ω(g(n))。
為了方便比較,我們可以將 f(n) 與 g(n) 比擬成 a 跟 b,則:
- f(n) ∈ Ο(g(n)) ≈ a ≤ b
- f(n) ∈ Ω(g(n)) ≈ a ≥ b
- f(n) ∈ Θ(g(n)) ≈ a = b
- f(n) ∈ ο(g(n)) ≈ a < b
- f(n) ∈ ω(g(n)) ≈ a > b
雖然存在這麼多種漸進符號以表達演算法的複雜度,但是一般來說,當我們分析一個演算法的複雜度,比較常使用 big-omicron 來表達估算後的結果。這是因為對於一個演算法,其所耗費的時間(或是記憶體)上限,通常才是我們需要關注的重點。
註1. 對於演算法所使用的記憶體空間,通常也是如此。
3月 05, 2010
【演算】演算法簡介 - Introduction of Algorithm
@
| 標籤:
演算
演算法(algorithm)出自於數學用語,指的是:在有限步驟內,解決一個問題的具體步驟和方法。其接受零或多個輸入資料,並在處理過後產生一個以上的輸出結果。
經由整理,我們可以知道,演算法必須具備以下特性:
舉例來說:由於長假閒著無聊,所以你想要打電話給多年未聯絡的的老朋友「郝仁」聊天敘敘舊。但是當你翻開電話簿,發現其中洋洋灑灑百餘個人名,該如何從中找到你想要的電話號碼呢?
當然你可以依序,從第一個名字一路找到最後一個。但是,假設電話簿早已依照姓氏筆畫排序,你何不省點功夫?我們可以隨意找到某個位置,若是筆劃比「郝」多一點,我們可以再往前翻一點;若是筆劃比「郝」少一點,我們可以在往後翻一點。直到找到「郝」這個姓氏為止。
上述提到的「找電話」,就是我們需要解決的「問題」。而這兩種方法(依序找跟按筆劃找),就是解決「找電話」這個問題的「演算法」(註1)。對於這個問題的「輸入」,就是你希望查到電話號碼的人(郝仁);而「輸出」理所當然是這個人的電話號碼了。
那麼,我們該如何描述我們所使用的演算法呢?
我們可以單純的採用文字描述。在上面「找電話」的例子,我用以描述這兩種「找電話」方法的方式就是文字敘述。換句話說,就是使用一般人較能接受的口語來描述演算法。
不過,由於用文字敘述容易造成文字太過冗長,且自然語言(如我們所說的語言:中文、英文、日文等,相對於程式語言等「人造語言」)的種類繁多,由不同的人來看可能會產生認知上的差異,而有所誤差。所以此種方式相較之下是比較不精確的。
既然用文字描述不太好,我們也可以直接利用實作出來的程式碼描述。如以下以 C 語言實作的「依序找電話」方法:
雖然這種方法不會有文字描述上的「冗長」跟「不精確」等缺點,但是因為這種方式往往需要考量到實作上的細節,也就是針對不同程式語言特性所需的程式撰寫或演算法的修改,使得演算法的描述無法完全專注在實際上的「執行步驟」上。
所以,虛擬碼(pseudocode)便為此應運而生了。
虛擬碼通常包括類似程式語言的文法和特定的關鍵字,再加上一些較自由的自然語言敘述,可以產生極良好的溝通效果,有助於對程式的瞭解。於是,我們可以將「依序找」的演算法以虛擬碼表示:
除此之外,我們還可以利用工業上經常使用的流程圖(flowchart)來描述演算法。流程圖使用各種標準化的符號、圖形來描述執行步驟與方式。如以下這個「依序找電話」演算法的流程圖範例:

相較於文字,顯然這種方式較容易看出演算法的流程,也比文字易懂的多。也因為圖形都經過標準化,因此在解讀上較不會出現解釋歧異的問題。
經由整理,我們可以知道,演算法必須具備以下特性:
- 有限性(Finiteness):演算法必須在有限的步驟內完成。
- 有效性(Effectiveness):演算法中的每個命令都必須為可執行的步驟。
- 正確性(Correctness):演算法所產生的結果必須是符合預期的。
- 明確性(Definiteness):演算法中的每個步驟必須是清楚明白、不含糊的。
- 輸入(Input):由外界提供的零或多筆資料。
- 輸出(Output):經由處理所得到的一個或多個結果。
舉例來說:由於長假閒著無聊,所以你想要打電話給多年未聯絡的的老朋友「郝仁」聊天敘敘舊。但是當你翻開電話簿,發現其中洋洋灑灑百餘個人名,該如何從中找到你想要的電話號碼呢?
當然你可以依序,從第一個名字一路找到最後一個。但是,假設電話簿早已依照姓氏筆畫排序,你何不省點功夫?我們可以隨意找到某個位置,若是筆劃比「郝」多一點,我們可以再往前翻一點;若是筆劃比「郝」少一點,我們可以在往後翻一點。直到找到「郝」這個姓氏為止。
上述提到的「找電話」,就是我們需要解決的「問題」。而這兩種方法(依序找跟按筆劃找),就是解決「找電話」這個問題的「演算法」(註1)。對於這個問題的「輸入」,就是你希望查到電話號碼的人(郝仁);而「輸出」理所當然是這個人的電話號碼了。
那麼,我們該如何描述我們所使用的演算法呢?
我們可以單純的採用文字描述。在上面「找電話」的例子,我用以描述這兩種「找電話」方法的方式就是文字敘述。換句話說,就是使用一般人較能接受的口語來描述演算法。
不過,由於用文字敘述容易造成文字太過冗長,且自然語言(如我們所說的語言:中文、英文、日文等,相對於程式語言等「人造語言」)的種類繁多,由不同的人來看可能會產生認知上的差異,而有所誤差。所以此種方式相較之下是比較不精確的。
既然用文字描述不太好,我們也可以直接利用實作出來的程式碼描述。如以下以 C 語言實作的「依序找電話」方法:
size_t index = 0;
char name[MAX_NAME_LENGTH];

scanf("%s", name);
while (true)
{
    if (index >= phoneBook.size)
    {
        printf("phone number not found");
        break;
    }

    if (strcmp(phoneBook.record[index].name, name) == 0)
    {
        printf("%s", phoneBook.record[index].phone);
        break;
    }

    index++;
}
雖然這種方法不會有文字描述上的「冗長」跟「不精確」等缺點,但是因為這種方式往往需要考量到實作上的細節,也就是針對不同程式語言特性所需的程式撰寫或演算法的修改,使得演算法的描述無法完全專注在實際上的「執行步驟」上。
所以,虛擬碼(pseudocode)便為此應運而生了。
虛擬碼通常包括類似程式語言的文法和特定的關鍵字,再加上一些較自由的自然語言敘述,可以產生極良好的溝通效果,有助於對程式的瞭解。於是,我們可以將「依序找」的演算法以虛擬碼表示:
Input name
While True do
    If index > phoneBook.size then
        Output "phone number not found"
        Break loop

    If phoneBook.record[index].name = name then
        Output phoneBook.record[index].phone
        Break loop

    index = index + 1
除此之外,我們還可以利用工業上經常使用的流程圖(flowchart)來描述演算法。流程圖使用各種標準化的符號、圖形來描述執行步驟與方式。如以下這個「依序找電話」演算法的流程圖範例:

相較於文字,顯然這種方式較容易看出演算法的流程,也比文字易懂的多。也因為圖形都經過標準化,因此在解讀上較不會出現解釋歧異的問題。
註1. 實際上,這個「找電話」問題就是典型的搜尋(search)問題,而這兩種尋找電話號碼的方法,則稱為所謂的「搜尋演算法(search algorithm)」。
12月 21, 2008
【目錄】演算法與資料結構
演算法與資料結構解說一覽
概論
‧演算法簡介 - Introduction of Algorithm
‧資料結構簡介 - Introduction of Data Structure - coming soon...
‧複雜度分析 - Complexity Analysis
‧非確定性多項式理論 - Non-deterministic Polynomial Theory - coming soon...
‧遞迴函式 - Recursive Function
資料結構
‧堆疊 - Stack
‧佇列 - Queue
‧連結串列 - Linked List
‧樹 - Tree
‧雜湊表 - Hash Table - coming soon...
演算法
‧排序演算法 - Sorting Algorithm
├ 氣泡排序法 - Bubble Sort
├ 選擇排序法 - Selection Sort
├ 插入排序法 - Insertion Sort
├ 合併排序法 - Mergesort
├ 快速排序法 - Quicksort
└ 堆積排序法 - Heapsort - coming soon...
‧搜尋演算法 - Search Algorithm
├ 循序搜尋法 - Linear Search
├ 二分搜尋法 - Binary Search
├ 內插搜尋法 - Interpolation Search
└ 費氏搜尋法 - Fibonacci Search - coming soon...
經典題型
‧大數運算 - Large Integer
├ Part 1. 介紹
├ Part 2. 加 / 減法原理
├ Part 3. 乘法原理
└ Part 4. 除法原理
‧斐波那契數列 - Fibonacci Sequence
‧老鼠走迷宮 - Mouse in a Maze
‧河內塔 - Tower of Hanoi
‧八皇后問題 - Eight Queens Puzzle
‧騎士巡邏 - Knight's Tour - coming soon...
‧約瑟夫問題 - Josephus Problem - coming soon...
‧背包問題 - Knapsack Problem - coming soon...
‧漢米爾頓迴路 - Hamiltonian Circuit - coming soon...
‧裝箱問題 - Bin-Packing Problem - coming soon...
【演算】內插搜尋法 - Interpolation Search
@
| 標籤:
演算
內插搜尋法(interpolation search)改良自二分搜尋法(binary search),也同樣都只能在資料已進行的情況下進行搜尋。但是,若在資料分布均勻時,其效率是會比二分搜尋法還高的。
既然內插搜尋法是改良自二分搜尋法,那麼實際的差異在哪呢?首先,內插搜尋法將資料的分布假設為一條直線:

若是一串資料於索引值 Ilow 與 Iupper 的值分別為 Klow 與 Kupper。假設我們需要找的目標值為 K,且 K 的索引值 I,則我們理應可以推得:(Kupper - Klow) / (Iupper - Ilow) = (K - Klow) / (I - Ilow)。
若整理以上的算式,便可以得到公式:I = Ilow + (Iupper - Ilow)(K - Klow) / Kupper - Klow。
舉例來說,現在我們需要在下面這些資料中搜尋數值 44:
則 I = 1 + [(10 - 1)(44 - 5) / (85 - 5)] = 5:
由於 37 小於目標值,因此我們對後面的資料進行同樣的搜尋,I = 6 + [(10 - 6)(44 - 44) / (85 - 44)] = 6:
發現第 I 項資料值等於搜尋值,這樣就找到欲尋找的值了。
內插搜尋法的虛擬碼大致如下:
平均而言,在有 n 筆資料的情況下,內插搜尋法只需要進行 log(log(n)) 次比對就可以找到資料!可見其效率之高。
但是,在資料並非分布均勻的最差情況下,內插搜尋法則是需要進行 n 次比對才能夠找到資料。此時的效率就比二分搜尋法低得多了。
以 C 語言的實作如下:
既然內插搜尋法是改良自二分搜尋法,那麼實際的差異在哪呢?首先,內插搜尋法將資料的分布假設為一條直線:

若是一串資料於索引值 Ilow 與 Iupper 的值分別為 Klow 與 Kupper。假設我們需要找的目標值為 K,且 K 的索引值 I,則我們理應可以推得:(Kupper - Klow) / (Iupper - Ilow) = (K - Klow) / (I - Ilow)。
若整理以上的算式,便可以得到公式:I = Ilow + (Iupper - Ilow)(K - Klow) / Kupper - Klow。
舉例來說,現在我們需要在下面這些資料中搜尋數值 44:
5 12 19 26 37 44 60 65 73 85
則 I = 1 + [(10 - 1)(44 - 5) / (85 - 5)] = 5:
5 12 19 26 37 44 60 65 73 85
由於 37 小於目標值,因此我們對後面的資料進行同樣的搜尋,I = 6 + [(10 - 6)(44 - 44) / (85 - 44)] = 6:
5 12 19 26 37 44 60 65 73 85
發現第 I 項資料值等於搜尋值,這樣就找到欲尋找的值了。
內插搜尋法的虛擬碼大致如下:
void interpolationSearch(Type data[1..n], Type search)
{
    Index low = 1;
    Index upper = n;

    while (low <= upper)
    {
        Index mid = low + (upper - low)
                      * (search - data[low])
                      / (data[upper] - data[low]);

        if (data[mid] = search)
        {
            print mid;
            return;
        }
        else if (data[mid] > search)
        {
            upper = mid - 1;
        }
        else if (data[mid] < search)
        {
            low = mid + 1;
        }
    }

    print "Not found";
}
平均而言,在有 n 筆資料的情況下,內插搜尋法只需要進行 log(log(n)) 次比對就可以找到資料!可見其效率之高。
但是,在資料並非分布均勻的最差情況下,內插搜尋法則是需要進行 n 次比對才能夠找到資料。此時的效率就比二分搜尋法低得多了。
以 C 語言的實作如下:
#include <stdio.h>
#include <stdlib.h>

int interpolationSearch(int[], int, int);

int main(void)
{
    int search, ans;
    int data[] = {5, 12, 19, 26, 37, 44, 60, 65, 73, 85};

    printf("請輸入欲搜尋的資料: ");
    scanf("%d", &search);

    // 呼叫函式進行搜尋
    ans = interpolationSearch(data, search, sizeof(data) / sizeof(int));

    if (ans < 0)
    {
        printf("找不到 %d\n", search);
    }
    else
    {
        printf("在第 %d 筆資料找到 %d\n", ans + 1, search);
    }

    system("pause");
}

int interpolationSearch(int data[], int search, int n)
{
    int low = 0, upper = n - 1;

    while (low <= upper)
    {
        int mid = low + (upper - low)
                      * (search - data[low])
                      / (data[upper] - data[low]);

        if (data[mid] == search)
        {
            return mid;
        }
        else if (data[mid] > search)
        {
            upper = mid - 1;
        }
        else if (data[mid] < search)
        {
            low = mid + 1;
        }
    }

    return -1;
}
12月 20, 2008
【演算】樹 - Tree
@
| 標籤:
演算
樹(tree)是一種資料結構(data structure),也就是我們一般所謂的「樹狀結構」或「樹狀圖」,為一個由根(root)向下延伸到葉子(leaf)的圖(graph)。

一棵樹由多個節點(node),以及連結各節點的邊(edge)所組成。
如同上面所提及的,樹的最頂層有一個唯一的根節點(root node),也就是上圖的節點 A,以及最末端的葉節點(leaf node),如上圖的節點 K、J、F、L、O、P。除了這些節點外,其餘的節點被稱為內部節點(internal node)。
每個節點都有其階層(level)、高度(height)以及深度(depth)。節點的階層代表節點間的世代關係,以根節點為第 1 階層,其子節點為第 2 階層,再下層為第 3 階層......,以此類推;節點的高度為節點到向下最遠葉節點的距離;而深度則為節點到根節點的距離。以上圖為例,G 節點的階層為 3、高度為 2、深度為 2。
而與節點連接的上層節點被稱為父節點(parent node),如上圖中的 G 即為 L 與 M 的父節點;與節點連接的下層結點被稱為子節點(child node),如上圖的 N 即為 H 的子節點。
且對於每一節點而言,除了根節點不具有父節點之外,其他節點都恰有一個父節點,及零個以上的子節點(葉節點不具有子節點)。除此之外,具有相同父節點的節點,則被稱為兄弟節點(sibling node),如上圖中的 D、E、F。
最後,節點的分支度(degree)代表子節點數量,如 A 節點的分支度為 2、B 節點的分支度為 3、C 節點的分支度為 2。
若就程式的觀點來看,樹是一個包含了其資料內容與 n (≧ 0)個指向子節點的指標的結構。一個樹的節點宣告方式大致如下:
而「樹」本身,只不過是一個總括的概念,其本身又可以細分為如二元樹(binary tree)等常見的樹結構。這些讓我們之後再一一進行說明。

一棵樹由多個節點(node),以及連結各節點的邊(edge)所組成。
如同上面所提及的,樹的最頂層有一個唯一的根節點(root node),也就是上圖的節點 A,以及最末端的葉節點(leaf node),如上圖的節點 K、J、F、L、O、P。除了這些節點外,其餘的節點被稱為內部節點(internal node)。
每個節點都有其階層(level)、高度(height)以及深度(depth)。節點的階層代表節點間的世代關係,以根節點為第 1 階層,其子節點為第 2 階層,再下層為第 3 階層......,以此類推;節點的高度為節點到向下最遠葉節點的距離;而深度則為節點到根節點的距離。以上圖為例,G 節點的階層為 3、高度為 2、深度為 2。
而與節點連接的上層節點被稱為父節點(parent node),如上圖中的 G 即為 L 與 M 的父節點;與節點連接的下層結點被稱為子節點(child node),如上圖的 N 即為 H 的子節點。
且對於每一節點而言,除了根節點不具有父節點之外,其他節點都恰有一個父節點,及零個以上的子節點(葉節點不具有子節點)。除此之外,具有相同父節點的節點,則被稱為兄弟節點(sibling node),如上圖中的 D、E、F。
最後,節點的分支度(degree)代表子節點數量,如 A 節點的分支度為 2、B 節點的分支度為 3、C 節點的分支度為 2。
若就程式的觀點來看,樹是一個包含了其資料內容與 n (≧ 0)個指向子節點的指標的結構。一個樹的節點宣告方式大致如下:
struct Node
{
    Type data;
    Node *next1;
    Node *next2;
    Node *next3;
        .
        .
        .
    Node *nextN;
}
而「樹」本身,只不過是一個總括的概念,其本身又可以細分為如二元樹(binary tree)等常見的樹結構。這些讓我們之後再一一進行說明。
11月 11, 2008
【演算】快速排序法 - Quicksort
@
| 標籤:
演算
快速排序法(quicksort)是目前被認為效率最高的排序演算法(sorting algorithm)。與合併排序法(mergesort)類似,快速排序法也是利用分治法(divide and conquer,D&C),不斷地將資料分成兩部分以解決問題的例子。
首先,快速排序法會從所有資料中選擇一個支點(pivot)(支點的挑選往往決定了快速排序法的執行效率。為了簡單起見,這裡我們都直接挑選最左邊的資料為支點)。然後,(假設我們需要將資料由小排到大)我們需要把所有小於支點的資料移動到支點之前、並把所有大於支點的資料移動到支點之後。
至於要怎麼移動呢?首先,我們先從資料的最左邊開始,尋找一個比支點還大的數字。並且同樣的,從資料的最右邊開始,尋找一個比支點還小的數字。接著,將兩筆資料交換。並重複同樣的動作,直到資料已分為「比支點小」與「比支點大」兩堆後,再將支點移動到兩者之間即可。
移動完成之後,我們將資料根據支點分割(partition)成兩份,再分別對其進行相同的挑選支點並移動的動作,直到完全排序完成為止。
舉例來說,若我們需要將以下資料由小排到大:
我們先從資料中挑選一個支點:
使「比支點小」與「比支點大」的兩堆資料分別移動至支點的兩邊:
將資料根據支點分成兩邊:
左邊的資料完成排序。從右邊的資料挑選支點:
使「比支點小」與「比支點大」的兩堆資料分別移動至支點的兩邊:
將資料根據支點分成兩邊:
接下來以此類推:
直到排序完成:
虛擬碼大致如下:
與先前介紹的合併排序法相同的,快速排序法比較的次數不易去計算,所以我們省略這個過程。不過需要知道的是,在最差情況時,快速排序法的執行時間會隨著資料大小為 n 的變化,形成 n2 曲線成長。
雖然看起來執行效率不佳,但是在平均情況下,快速排序法執行時間的成長速率卻只有 n log n!可見在大多數情況下,快速排序法的效率仍然是相當優秀的。
以下是使用 C 語言的實現:
首先,快速排序法會從所有資料中選擇一個支點(pivot)(支點的挑選往往決定了快速排序法的執行效率。為了簡單起見,這裡我們都直接挑選最左邊的資料為支點)。然後,(假設我們需要將資料由小排到大)我們需要把所有小於支點的資料移動到支點之前、並把所有大於支點的資料移動到支點之後。
至於要怎麼移動呢?首先,我們先從資料的最左邊開始,尋找一個比支點還大的數字。並且同樣的,從資料的最右邊開始,尋找一個比支點還小的數字。接著,將兩筆資料交換。並重複同樣的動作,直到資料已分為「比支點小」與「比支點大」兩堆後,再將支點移動到兩者之間即可。
移動完成之後,我們將資料根據支點分割(partition)成兩份,再分別對其進行相同的挑選支點並移動的動作,直到完全排序完成為止。
舉例來說,若我們需要將以下資料由小排到大:
26 13 73 31 38
我們先從資料中挑選一個支點:
26 13 73 31 38
使「比支點小」與「比支點大」的兩堆資料分別移動至支點的兩邊:
13 26 73 31 38
將資料根據支點分成兩邊:
(13) 26 (73 31 38)
左邊的資料完成排序。從右邊的資料挑選支點:
13 26 (73 31 38)
使「比支點小」與「比支點大」的兩堆資料分別移動至支點的兩邊:
13 26 (38 31 73)
將資料根據支點分成兩邊:
13 26 (38 31) 73
接下來以此類推:
13 26 (38 31) 73
13 26 (31 38) 73
13 26 (31) 38 73
直到排序完成:
13 26 31 38 73
虛擬碼大致如下:
void quicksort(Type data[1..n], Index left, Index right)
{
    if (left >= right) { return; }

    Type pivot = data[left];

    Index i = left + 1;
    Index j = right;
    while (1)
    {
        while (i <= right)
        {
            if (data[i] > pivot)
            {
                break;
            }

            i = i + 1;
        }

        while (j > left)
        {
            if (data[j] < pivot)
            {
                break;
            }

            j = j - 1;
        }

        if (i > j) { break; }

        exchange data[i] and data[j]
    }

    exchange data[left] and data[j]

    quicksort(data, left, j - 1);
    quicksort(data, j + 1, right);
}與先前介紹的合併排序法相同的,快速排序法比較的次數不易去計算,所以我們省略這個過程。不過需要知道的是,在最差情況時,快速排序法的執行時間會隨著資料大小為 n 的變化,形成 n2 曲線成長。
雖然看起來執行效率不佳,但是在平均情況下,快速排序法執行時間的成長速率卻只有 n log n!可見在大多數情況下,快速排序法的效率仍然是相當優秀的。
以下是使用 C 語言的實現:
#include <stdio.h>
#include <stdlib.h>

void quicksort(int *data, int left, int right);
void swap(int *a, int *b);

int main(void)
{
    int i, n, data[10];

    printf("請輸入資料筆數 n(<= 10): ");
    scanf("%d", &n);

    for (i = 0; i < n; i++)
    {
        printf("請輸入第 %d 筆資料: ", i + 1);
        scanf("%d", &data[i]);
    }

    // 執行快速排序法
    quicksort(data, 0, n - 1);

    printf("\n排序後的結果: ");
    for (i = 0; i < n; i++)
    {
        printf("%d ", data[i]);
    }

    printf("\n");
    system("pause");
}

void quicksort(int *data, int left, int right)
{
    int pivot, i, j;

    if (left >= right) { return; }

    pivot = data[left];

    i = left + 1;
    j = right;

    while (1)
    {
        while (i <= right)
        {
            if (data[i] > pivot)
            {
                break;
            }

            i = i + 1;
        }

        while (j > left)
        {
            if (data[j] < pivot)
            {
                break;
            }

            j = j - 1;
        }

        if (i > j) { break; }

        swap(&data[i], &data[j]);
    }

    swap(&data[left], &data[j]);

    quicksort(data, left, j - 1);
    quicksort(data, j + 1, right);
}

void swap(int *a, int *b)
{
    int temp = *a;
    *a = *b;
    *b = temp;
}
8月 07, 2008
【演算】二分搜尋法 - Binary Search
@
| 標籤:
演算
二分搜尋法(binary search)用以搜尋已排序的一串資料。其原理為將欲搜尋的值,與所有資料的中間值(中位數)做比對。
假設在資料由小排到大的情況,若是搜尋值與中間值不同,且搜尋值比中間值為大。由於資料經過排序,我們可以得知:中間值以前的資料全都比搜尋值還小,所以我們就不需要再浪費時間搜尋這個範圍的值。
相反的,若是搜尋值比中間值為小,我們也可以得知:中間值以後的資料全都比搜尋值還大,也代表接下來我們不需要去尋找中間值以後的值。
接著,由於搜尋到資料的可能範圍僅剩下一半(中間值之前或之後)。我們運用同樣的方式,取出這個範圍資料的中間值與搜尋值做比對。再依據此中間值將資料分成兩半,直到找到搜尋值為止。
舉例來說,現在我們需要在下面這些資料中搜尋數值 44:
由於中間值 41 小於搜尋值 44。因此我們可以知道,在 41 之前的資料皆小於搜尋值 44。
接著,由於 41 之後資料中的中間值 57 大於搜尋值 44。我們可以知道,在 57 之前的資料皆大於搜尋值 44。
接著我們將 41 與 57 之間的中間值與搜尋值比對。發現中間值 44 等於搜尋值,這次就找到欲尋找的值了。
二分搜尋的虛擬碼大致如下:
若是有 n 筆資料,在最差的情況下,二分搜尋法總共需要比較 [log2n] + 1 次。
顯然的,此種搜尋法較循序搜尋法(linear search)快速許多。
以 C 語言的實作如下:
假設在資料由小排到大的情況,若是搜尋值與中間值不同,且搜尋值比中間值為大。由於資料經過排序,我們可以得知:中間值以前的資料全都比搜尋值還小,所以我們就不需要再浪費時間搜尋這個範圍的值。
相反的,若是搜尋值比中間值為小,我們也可以得知:中間值以後的資料全都比搜尋值還大,也代表接下來我們不需要去尋找中間值以後的值。
接著,由於搜尋到資料的可能範圍僅剩下一半(中間值之前或之後)。我們運用同樣的方式,取出這個範圍資料的中間值與搜尋值做比對。再依據此中間值將資料分成兩半,直到找到搜尋值為止。
舉例來說,現在我們需要在下面這些資料中搜尋數值 44:
3 7 14 20 23 32 41 44 56 57 73 89 93
由於中間值 41 小於搜尋值 44。因此我們可以知道,在 41 之前的資料皆小於搜尋值 44。
3 7 14 20 23 32 41 44 56 57 73 89 93
接著,由於 41 之後資料中的中間值 57 大於搜尋值 44。我們可以知道,在 57 之前的資料皆大於搜尋值 44。
3 7 14 20 23 32 41 44 56 57 73 89 93
接著我們將 41 與 57 之間的中間值與搜尋值比對。發現中間值 44 等於搜尋值,這次就找到欲尋找的值了。
二分搜尋的虛擬碼大致如下:
void binarysearch(Type data[1..n], Type search)
{
    Index low = 1;
    Index high = n;

    while (low <= high)
    {
        Index mid = (low + high) / 2;

        if (data[mid] = search)
        {
            print mid;
            return;
        }
        else if (data[mid] > search)
        {
            high = mid - 1;
        }
        else if (data[mid] < search)
        {
            low = mid + 1;
        }
    }

    print "Not found";
}
若是有 n 筆資料,在最差的情況下,二分搜尋法總共需要比較 [log2n] + 1 次。
顯然的,此種搜尋法較循序搜尋法(linear search)快速許多。
以 C 語言的實作如下:
#include <stdio.h>
#include <stdlib.h>

int binarysearch(int[], int, int);

int main(void)
{
    int search, ans;
    int data[] = {3, 7, 14, 20, 23, 32, 41, 44, 56, 57, 73, 89, 93};

    printf("請輸入欲搜尋的資料: ");
    scanf("%d", &search);

    // 呼叫函式進行搜尋
    ans = binarysearch(data, search, sizeof(data) / sizeof(int));

    if (ans < 0)
    {
        printf("找不到 %d\n", search);
    }
    else
    {
        printf("在第 %d 筆資料找到 %d\n", ans + 1, search);
    }

    system("pause");
}

int binarysearch(int data[], int search, int n)
{
    int low = 0, high = n - 1;

    while (low <= high)
    {
        int mid = (low + high) / 2;

        if (data[mid] == search)
        {
            return mid;
        }
        else if (data[mid] > search)
        {
            high = mid - 1;
        }
        else if (data[mid] < search)
        {
            low = mid + 1;
        }
    }

    return -1;
}
8月 02, 2008
【演算】循序搜尋法 - Linear Search
@
| 標籤:
演算
循序搜尋法(linear search)屬於較簡易的搜尋演算法(search algorithm),一般而言最常拿來介紹「搜尋」的概念。其執行原理如同其名,就是從第一個資料開始,依序尋找比對每一筆資料。
假設現在共有 n 筆資料,循序搜尋法的虛擬碼大致如下:
由於循序搜尋法會依序比對每一筆資料,所以其最大搜尋時間(最壞情況)為資料大小 n,就算是平均搜尋時間也有 n / 2。
我們可以發現到,循序搜尋法的搜尋時間會與資料量 n 成正比。所以這種搜尋演算法效率並不高,一般來說並不太實用。
以下是使用 C 語言的實作:
假設現在共有 n 筆資料,循序搜尋法的虛擬碼大致如下:
void linearsearch(Type data[1..n], Type search)
{
    Index i;

    for (i = 1 to n)
    {
        if (data[i] = search)
        {
            print i;
            return;
        }
    }

    print "Not found";
}
由於循序搜尋法會依序比對每一筆資料,所以其最大搜尋時間(最壞情況)為資料大小 n,就算是平均搜尋時間也有 n / 2。
我們可以發現到,循序搜尋法的搜尋時間會與資料量 n 成正比。所以這種搜尋演算法效率並不高,一般來說並不太實用。
以下是使用 C 語言的實作:
#include <stdio.h>
#include <stdlib.h>

int linearsearch(int[], int);

int n;

int main(void)
{
    int i, search, ans;
    int* data;

    printf("請輸入資料筆數: ");
    scanf("%d", &n);

    // 動態分配記憶體
    data = malloc(sizeof(int) * n);

    for (i = 0; i < n; i++)
    {
        printf("請輸入第 %d 筆資料: ", i + 1);
        scanf("%d", &data[i]);
    }

    printf("請輸入欲搜尋的資料: ");
    scanf("%d", &search);

    // 呼叫函式進行搜尋
    ans = linearsearch(data, search);

    if (ans < 0)
    {
        printf("找不到 %d\n", search);
    }
    else
    {
        printf("在第 %d 筆資料找到 %d\n", ans + 1, search);
    }

    // 釋放記憶體空間
    free(data);

    system("pause");
}

int linearsearch(int data[], int search)
{
    int i;

    for (i = 0; i < n; i++)
    {
        if (data[i] == search)
        {
            return i;
        }
    }

    return -1;
}
【演算】斐波那契數列 - Fibonacci Sequence
@
| 標籤:
演算
斐波那契數列(Fibonacci Sequence)得名於暱稱為 Fibonacci 的義大利數學家 Leonardo of Pisa。斐波那契數列由 0 和 1 開始,第 3 項之後的值則為前兩項之和。數學上的定義如下:
對電算概論而言,斐波那契數列則時常用來解釋遞迴(recursion)的概念。舉例來說,以下是以遞迴實現斐波那契數列的虛擬碼:
不過,這種方式雖然直覺而且簡單,但是其執行效率卻相當差。因為在需要求出 Fn (n > 1) 值的同時,我們也必須得到 Fn - 1 與 Fn - 2 的值。而為了得出 Fn - 1 的值,又必須再重複求出 Fn - 2 的值。
不斷重複求出同樣的值的結果,就是浪費太多的程式時間。因此只要 n 大到一個程度,程式就幾乎無法在短時間內得出結果了。
那麼,還有什麼方法呢?
其實我們可以使用陣列搭配迴圈來做到。請看以下虛擬碼:
我們也可以只利用三個變數來達成相同功能。請看以下虛擬碼:
至於程式語言的實作,由於之前在 96 學年度北市高中資訊競賽的會議中心 (Room)已經寫過,這裡就不重複貼出了。
* F0 = 0
* F1 = 1
* Fn = Fn - 1 + Fn - 2 (n > 1)

對電算概論而言,斐波那契數列則時常用來解釋遞迴(recursion)的概念。舉例來說,以下是以遞迴實現斐波那契數列的虛擬碼:
int Fibonacci(Index n)
{
    if      (n = 0) { return 0; }
    else if (n = 1) { return 1; }
    else
    {
        return Fibonacci(Index - 1) + Fibonacci(Index - 2);
    }
}
不過,這種方式雖然直覺而且簡單,但是其執行效率卻相當差。因為在需要求出 Fn (n > 1) 值的同時,我們也必須得到 Fn - 1 與 Fn - 2 的值。而為了得出 Fn - 1 的值,又必須再重複求出 Fn - 2 的值。
不斷重複求出同樣的值的結果,就是浪費太多的程式時間。因此只要 n 大到一個程度,程式就幾乎無法在短時間內得出結果了。
那麼,還有什麼方法呢?
其實我們可以使用陣列搭配迴圈來做到。請看以下虛擬碼:
void Fibonacci(Index n)
{
    Index i;

    F[0] = 0;
    F[1] = 1;

    for (i = 2 to n)
    {
        F[i] = F[i - 1] + F[i - 2];
    }

    print F[n];
}
我們也可以只利用三個變數來達成相同功能。請看以下虛擬碼:
void Fibonacci(Index n)
{
    if      (n = 0) { return 0; }
    else if (n = 1) { return 1; }
    else
    {
        Index i;

        F[0] = 0;
        F[1] = 1;

        for (i = 2 to n)
        {
            F[2] = F[0] + F[1];

            F[0] = F[1];
            F[1] = F[2];
        }

        print F[3];
    }
}
至於程式語言的實作,由於之前在 96 學年度北市高中資訊競賽的會議中心 (Room)已經寫過,這裡就不重複貼出了。
7月 31, 2008
【演算】八皇后問題 - Eight Queens Puzzle
@
| 標籤:
演算
我想有不少人玩過西洋棋(chess)這種棋奕遊戲。其中,有一種棋子 - 后(Queen)除了可以直走、橫走,還可以往斜直線的方向走。而八皇后問題(Eight Queens Puzzle)就是在一個 8 × 8 的西洋棋盤上,使八個皇后全部放在棋盤上,而不能被其他皇后吃掉。
這個問題還能夠加以衍伸,變成「在一個 n × n 的西洋棋盤上,使 n 個皇后全部放在棋盤上,而不能被其他皇后吃掉」的 n 皇后問題。
若是只需要輸出其中一種排法,我們可以使用遞迴求解。嘗試每一種棋子擺放的方式,再找出符合條件(皇后間無法互相攻擊)的擺法。上述的狀態空間樹(state space tree)如下圖(為簡化作圖,這裡的 n = 4):

[i, j] 代表第 i 行的皇后擺在第 j 列上。這棵樹的葉節點(leaf nodes),即為此問題所有可能解的集合。而上圖的狀態空間樹,總共有 256 (44) 個葉節點。
不過,這種方式還是相當沒效率,所以我們必須想辦法減少遞迴的次數。
首先我們知道,因為皇后可以橫向、直向與斜向移動,所以我們可以在遞迴前先判斷:現在這個皇后放置的位置,是否會與其他皇后衝突。上述的狀態空間樹如下圖所示:

跟前一張圖比較,節點 [1, 1] 之下的 [2, 1] 與 [2, 2] 因為會與 [1, 1] 衝突,所以遞迴時不會走訪這個節點。同理,節點 [2, 3] 之下的所有節點,因為會與 [1, 1] 或 [2, 3] 衝突,所以遞迴時也不會走訪這個節點。
如此就可以有效的減少遞迴的次數。這種方式就稱之為修剪(pruning)。
至於要如何判斷某位置是否會與其他皇后衝突呢?我的方式是使用分別作列、左斜與右斜的陣列。每放置一個皇后,就標記其相對應的三個變數值。
完整的虛擬碼大致如下:
以下是使用 C 語言的實現:
這個問題還能夠加以衍伸,變成「在一個 n × n 的西洋棋盤上,使 n 個皇后全部放在棋盤上,而不能被其他皇后吃掉」的 n 皇后問題。
若是只需要輸出其中一種排法,我們可以使用遞迴求解。嘗試每一種棋子擺放的方式,再找出符合條件(皇后間無法互相攻擊)的擺法。上述的狀態空間樹(state space tree)如下圖(為簡化作圖,這裡的 n = 4):

[i, j] 代表第 i 行的皇后擺在第 j 列上。這棵樹的葉節點(leaf nodes),即為此問題所有可能解的集合。而上圖的狀態空間樹,總共有 256 (44) 個葉節點。
不過,這種方式還是相當沒效率,所以我們必須想辦法減少遞迴的次數。
首先我們知道,因為皇后可以橫向、直向與斜向移動,所以我們可以在遞迴前先判斷:現在這個皇后放置的位置,是否會與其他皇后衝突。上述的狀態空間樹如下圖所示:

跟前一張圖比較,節點 [1, 1] 之下的 [2, 1] 與 [2, 2] 因為會與 [1, 1] 衝突,所以遞迴時不會走訪這個節點。同理,節點 [2, 3] 之下的所有節點,因為會與 [1, 1] 或 [2, 3] 衝突,所以遞迴時也不會走訪這個節點。
如此就可以有效的減少遞迴的次數。這種方式就稱之為修剪(pruning)。
至於要如何判斷某位置是否會與其他皇后衝突呢?我的方式是使用分別作列、左斜與右斜的陣列。每放置一個皇后,就標記其相對應的三個變數值。
完整的虛擬碼大致如下:
void queens(Index x)
{
    Index i;

    for (i = 1 to n)
    {
        Index j = i - x + n;
        Index k = x + i + 1;

        if (column[i] and right[j] and left[k])
        {
            column[i] = right[j] = left[k] = false;

            queen(x + 1);

            column[i] = right[j] = left[k] = true;
        }
    }
}
以下是使用 C 語言的實現:
#include <stdio.h>
#include <stdlib.h>

void queens(int x);
void print(void);

unsigned int n, num;
char** checkerboard;
int* column;
int* right;
int* left;

int main(void)
{
    int i, j;

    printf("請輸入 n 的大小: ");
    scanf("%d", &n);

    // 動態分配記憶體
    column = malloc(sizeof(int) * n);
    right = malloc(sizeof(int) * (2 * n - 1));
    left = malloc(sizeof(int) * (2 * n - 1));
    checkerboard = malloc(sizeof(char*) * n);

    // 變數初始化
    num = 0;
    for (i = 0; i < n; i++)
    {
        column[i] = 1;

        checkerboard[i] = malloc(sizeof(char) * n);
        for (j = 0; j < n; j++)
        {
            checkerboard[i][j] = 'x';
        }
    }

    for (i = 0; i < 2 * n - 1; i++)
    {
        right[i] = left[i] = 1;
    }

    queens(0);

    printf("\n總共有 %d 種排法\n\n", num);

    // 釋放記憶體空間
    for (i = 0; i < n; i++)
    {
        free(checkerboard[i]);
    }

    free(checkerboard);
    free(column);
    free(right);
    free(left);

    system("pause");
}

void queens(int x)
{
    if (x < n)
    {
        int i;
        for (i = 0; i < n; i++)
        {
            int j = i - x + n - 1;
            int k = i + x;

            if (column[i] && right[j] && left[k])
            {
                // 標記皇后位置, 並遞迴放置下一個
                column[i] = right[j] = left[k] = 0;
                checkerboard[x][i] = 'Q';

                queens(x + 1);

                column[i] = right[j] = left[k] = 1;
                checkerboard[x][i] = 'x';
            }
        }
    }
    else
    {
        // 輸出棋盤
        print();
        num++;
    }
}

void print(void)
{
    int i, j;

    printf("\n");
    for(i = 0; i < n; i++)
    {
        for(j = 0; j < n; j++)
        {
            printf("%c", checkerboard[i][j]);
        }

        printf("\n");
    }
}
6月 21, 2008
【演算】河內塔 - Tower of Hanoi
@
| 標籤:
演算
河內塔問題(Tower of Hanoi)是由法國數學家盧卡斯(Édouard Lucas)引進的數學謎題:在 3 根桿子中,有 1 桿上有 N 個從下數起由大而小的穿孔圓盤。在每次只能移動一個圓盤,且大盤不能疊在小盤之上的規則之下,你需要以最少的次數將這 N 個圓盤全部移到另一根桿子上。

這個遊戲乍看起來有點複雜,其實解法相當簡單(為了方便起見,我們分別將三根桿子標記成 A, B, C,且都是將圓盤由 A 桿移向 C 桿)。
假設現在 A 桿上有 1 個圓盤,則直接將之移到 C 桿上。若是有 A 桿上有兩個圓盤,則先將第 1 個(最小的)圓盤移到 B 桿上,再將 A 桿剩下的第 2 個圓盤移到 C 桿上,最後將剛剛移到 B 桿上的第 1 個圓盤移到 C 桿第 2 個圓盤之上即可。
若是 3 個圓盤的情況呢?這時我們需要先忽略第 3 個圓盤,先把前 2 個圓盤以上述的方式移到 B 桿,再將第 3 個圓桿移到 C 桿之後,最後將 B 桿上的 2 個圓盤循同樣的方式移到 C 桿第 3 個圓盤之上即可。
所以同樣的,若是 4 個圓盤,就將前 3 層以一樣的方式移到 B 桿,再將第 4 個圓盤移到 C 桿上,最後再把 B 桿上的圓盤全部移到 C 桿上。
至於更多圓盤的情況,其實也都是運用這種規律解開。以下是 3 層與 4 層河內塔的最少移動解法圖例:


而這種河內塔解法,其實就類似程式的遞迴(recursion)。
怎麼說呢?假設現在你需要將一個 N 層河內塔由 A 桿移到 C 桿。依照上面的解法,我們需要先將前 N - 1 層的圓盤先移到 B 桿,再將第 N 層的圓盤移到 C 桿,最後將 B 桿上的圓盤全部移到 C 桿。
而要怎麼將前 N - 1 層的圓盤由 A 桿移到 B 桿呢?也是運用同樣的方式:將前 N - 2 層的圓盤先移到 A 桿,再將第 N 層的圓盤移到 B 桿,最後將 A 桿上的圓盤全部移到 B 桿。
就這樣下去,直到變成最簡易的移動 1 層圓盤為止。也就是說,遞迴的終止條件為移動的圓盤數 n = 1。
以下是解河內塔謎題的虛擬碼:
最後,附上 C 語言的程式實作:
小小的補充一下,假如用以上的程式去試看看,可以發現 N 層河內塔的最小移動次數恰好是 2n - 1。

這個遊戲乍看起來有點複雜,其實解法相當簡單(為了方便起見,我們分別將三根桿子標記成 A, B, C,且都是將圓盤由 A 桿移向 C 桿)。
假設現在 A 桿上有 1 個圓盤,則直接將之移到 C 桿上。若是有 A 桿上有兩個圓盤,則先將第 1 個(最小的)圓盤移到 B 桿上,再將 A 桿剩下的第 2 個圓盤移到 C 桿上,最後將剛剛移到 B 桿上的第 1 個圓盤移到 C 桿第 2 個圓盤之上即可。
若是 3 個圓盤的情況呢?這時我們需要先忽略第 3 個圓盤,先把前 2 個圓盤以上述的方式移到 B 桿,再將第 3 個圓桿移到 C 桿之後,最後將 B 桿上的 2 個圓盤循同樣的方式移到 C 桿第 3 個圓盤之上即可。
所以同樣的,若是 4 個圓盤,就將前 3 層以一樣的方式移到 B 桿,再將第 4 個圓盤移到 C 桿上,最後再把 B 桿上的圓盤全部移到 C 桿上。
至於更多圓盤的情況,其實也都是運用這種規律解開。以下是 3 層與 4 層河內塔的最少移動解法圖例:


而這種河內塔解法,其實就類似程式的遞迴(recursion)。
怎麼說呢?假設現在你需要將一個 N 層河內塔由 A 桿移到 C 桿。依照上面的解法,我們需要先將前 N - 1 層的圓盤先移到 B 桿,再將第 N 層的圓盤移到 C 桿,最後將 B 桿上的圓盤全部移到 C 桿。
而要怎麼將前 N - 1 層的圓盤由 A 桿移到 B 桿呢?也是運用同樣的方式:將前 N - 2 層的圓盤先移到 A 桿,再將第 N 層的圓盤移到 B 桿,最後將 A 桿上的圓盤全部移到 B 桿。
就這樣下去,直到變成最簡易的移動 1 層圓盤為止。也就是說,遞迴的終止條件為移動的圓盤數 n = 1。
以下是解河內塔謎題的虛擬碼:
void Hanoi(Index n, char A, char B, char C)
{
    if (n = 1)
    {
        print "將第" n "個圓盤由" A "移到" C;
    }
    else
    {
        Hanoi(n - 1, A, C, B);
        print "將第" n "個圓盤由" A "移到" C;
        Hanoi(n - 1, B, A, C);
    }
}
最後,附上 C 語言的程式實作:
#include <stdio.h>
#include <stdlib.h>

void hanoi(int, char, char, char);

int time = 0;

int main(void)
{
    int n;

    printf("請輸入河內塔的高度:");
    scanf("%d", &n);

    hanoi(n, 'A', 'B', 'C');

    printf("移動 %d 層河內塔共需移動 %d 次\n", n, time);

    system("pause");
}

void hanoi(int n, char A, char B, char C)
{
    if (n == 1)
    {
        printf("%d: 將第 %d 個圓盤由 %c 移到 %c\n", ++time, n, A, C);
    }
    else
    {
        hanoi(n - 1, A, C, B);
        printf("%d: 將第 %d 個圓盤由 %c 移到 %c\n", ++time, n, A, C);
        hanoi(n - 1, B, A, C);
    }
}
小小的補充一下,假如用以上的程式去試看看,可以發現 N 層河內塔的最小移動次數恰好是 2n - 1。
5月 31, 2008
【演算】老鼠走迷宮 - Mouse in a Maze
@
| 標籤:
演算
老鼠走迷宮是訓練使用堆疊(或是遞迴)的一種經典題型。老鼠可以往上、下、左、右四個方向前進,你必須讓這隻老鼠在迷宮中,由給定的起點走到終點。
而這題最簡單的作法,就是由起點開始向四個方向測試,並將走過的路徑做個標示,以防止走過相同的路。一旦發現現在的走法無法走到終點,則追朔回之前的路徑,並將當前的標示清除。
這樣敘述或許比較抽象。假設迷宮的起點在(XS, YS)、終點在(XE, YE)。迷宮存在 maze 這個二維陣列之中,若 maze[x][y] = 1 則代表牆壁,maze[x][y] = 0 則代表可以通行。那麼,解題的虛擬碼就像這樣:
假如還是不太瞭解,我有使用 C++ 以這個方式,作出一個老鼠走迷宮的範例:

程式採用標準輸入,第一行的兩個數字 n, m 代表迷宮的高與寬。接下來的 n * m 個數字代表迷宮,1 代表牆壁、0 代表可以通行。最後的四個數字分別代表起點的 x 座標、起點的 y 座標、終點的 x 座標、終點的 y 座標。
附屬的文字檔是我做出來的範例迷宮。假如要使用則在命令列模式,至該檔案目錄輸入以下指令:
Maze < Maze.txt
除此之外,若是想看到老鼠尋路的方式,可以輸入以下指令(紅字請自行更改,代表每一步延遲多久。單位是千分之ㄧ秒):
Maze < Maze.txt 500
而這題最簡單的作法,就是由起點開始向四個方向測試,並將走過的路徑做個標示,以防止走過相同的路。一旦發現現在的走法無法走到終點,則追朔回之前的路徑,並將當前的標示清除。
這樣敘述或許比較抽象。假設迷宮的起點在(XS, YS)、終點在(XE, YE)。迷宮存在 maze 這個二維陣列之中,若 maze[x][y] = 1 則代表牆壁,maze[x][y] = 0 則代表可以通行。那麼,解題的虛擬碼就像這樣:
bool visit(index x, index y)
{
    bool success = false;

    gone[x][y] = true;

    if ((maze[x][y + 1] != 1 and visit(x, y + 1) = true) or
        (maze[x + 1][y] != 1 and visit(x + 1, y) = true) or
        (maze[x][y - 1] != 1 and visit(x, y - 1) = true) or
        (maze[x - 1][y] != 1 and visit(x - 1, y) = true))
    {
        success = true;
    }
    else
    {
        gone[x][y] = false;
    }

    return success;
}
假如還是不太瞭解,我有使用 C++ 以這個方式,作出一個老鼠走迷宮的範例:
程式採用標準輸入,第一行的兩個數字 n, m 代表迷宮的高與寬。接下來的 n * m 個數字代表迷宮,1 代表牆壁、0 代表可以通行。最後的四個數字分別代表起點的 x 座標、起點的 y 座標、終點的 x 座標、終點的 y 座標。
附屬的文字檔是我做出來的範例迷宮。假如要使用則在命令列模式,至該檔案目錄輸入以下指令:
Maze < Maze.txt
除此之外,若是想看到老鼠尋路的方式,可以輸入以下指令(紅字請自行更改,代表每一步延遲多久。單位是千分之ㄧ秒):
Maze < Maze.txt 500
5月 23, 2008
【演算】連結串列 - Linked List
@
| 標籤:
演算
當你需要儲存一串同型資料時,使用陣列或許是一個最簡單的方法。但是由於陣列在宣告時,就需要明確的指定大小。在資料不多(比陣列大小小)時,就容易造成記憶體的浪費。反之資料多(比陣列大小大)時,也會出現記憶體空間上使用限制。
而連結串列(linked list),可以說就是為了解決這些缺陷而出現的。串列的最大特色,就是其大小可因應需求動態配置記憶體,避免記憶體的浪費。不過相對的,串列的實現與操作也較陣列麻煩許多。
串列中的每一個元素稱之為節點(node),每一個節點都包含了儲存資料的變數,以及連結其他節點的連結指標(linked list 之名便是有此而來)。
根據不同情況,比較常見的串列有單向連結串列(singly-linked lists)、雙向連結串列(doubly-linked lists)與環狀連結串列(circularly-linked lists)。
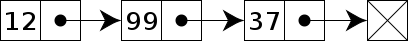
單向連結串列是一個最基本的串列,每一個節點都包含一個指向下一個節點的指標。
一個節點的宣告方式大致如下:
而串列的操作,大致有插入(insert)跟移除(remove)這兩種方式。
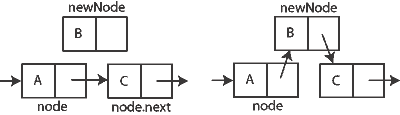
插入操作的進行,其實只是指標指向的轉移。假設現在欲在 A 與 C 節點中插入一個 B 節點,則先將 B 節點的連結指標指向 C,再將 A 節點的連結指標指向 B。
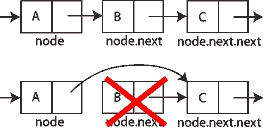
相同的,移除操作也是藉由指標指向的轉移達成。假設現在我們要將 A 與 C 節點中的 B 節點移除,則將 A 節點的連結指標指向 C 即可。
以上兩種操作的虛擬碼大致如下:
以下是使用 C 語言的實作單向連結串列的使用實例:
至於雙向連結串列,則是結點比單向連結串列多了一個連結指標,指向的是這個節點的前一個節點。

而環狀連結串列跟單向連結串列僅有唯一不同點,就是環狀連結串列的最後一個節點指標指向的是第一個節點。
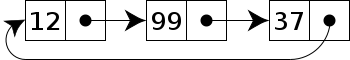
至於這兩種連結串列的操作,基本上與單向連結串列大同小異,這裡我們不再多花篇幅解釋(格主想睡了)。
儘管連結串列在資料的新增與移除上,較陣列來的彈性許多,它也是具有許多缺點的。
除了一開始我所提到的操作麻煩之外,由於串列沒有索引值,因此要提取某節點存放的變數值會相當不方便。而且若是一個連結串列的節點相當多,每一個節點指標所佔用的記憶體也相當龐大。
因此,根據不同的情況,判斷何時用陣列、何時用串列,也是相當重要的。
而連結串列(linked list),可以說就是為了解決這些缺陷而出現的。串列的最大特色,就是其大小可因應需求動態配置記憶體,避免記憶體的浪費。不過相對的,串列的實現與操作也較陣列麻煩許多。
串列中的每一個元素稱之為節點(node),每一個節點都包含了儲存資料的變數,以及連結其他節點的連結指標(linked list 之名便是有此而來)。
根據不同情況,比較常見的串列有單向連結串列(singly-linked lists)、雙向連結串列(doubly-linked lists)與環狀連結串列(circularly-linked lists)。
單向連結串列是一個最基本的串列,每一個節點都包含一個指向下一個節點的指標。

一個節點的宣告方式大致如下:
struct Node
{
    Type data;
    Node *next;
}
而串列的操作,大致有插入(insert)跟移除(remove)這兩種方式。
插入操作的進行,其實只是指標指向的轉移。假設現在欲在 A 與 C 節點中插入一個 B 節點,則先將 B 節點的連結指標指向 C,再將 A 節點的連結指標指向 B。

相同的,移除操作也是藉由指標指向的轉移達成。假設現在我們要將 A 與 C 節點中的 B 節點移除,則將 A 節點的連結指標指向 C 即可。

以上兩種操作的虛擬碼大致如下:
void insert(Node* n1, Node* n2)
{
    // 將 n2 插入在 n1 之後
    n2->next = n1->next;
    n1->next = n2;
}

void remove(Node* n1)
{
    // 刪除 n1 的下一個節點
    n1->next = n1->next->next;
}
以下是使用 C 語言的實作單向連結串列的使用實例:
#include <stdio.h>
#include <stdlib.h>

// 宣告節點結構
typedef struct ns
{
    int data;
    struct ns* next;
} node;

// 宣告相關函式
node* create_node(int);
void insert_node(node*, node*);
void remove_node(node*);
void print_lists(node*);
void free_lists(node*);

int main(void)
{
    // 宣告節點
    node* lists = create_node(0);
    node* a = create_node(1);
    node* b = create_node(2);
    node* c = create_node(3);
    node* d = create_node(4);
    node* e = create_node(5);

    // 0 -> 5
    insert_node(lists, e);

    // 0 -> 1 -> 5
    insert_node(lists, a);

    // 1 -> 2 -> 5
    insert_node(a, b);

    // 1 -> 3 -> 2
    insert_node(a, c);

    // 5 -> 4
    insert_node(e, d);

    print_lists(lists);
    free_lists(lists);

    system("pause");
}

node* create_node(int data)
{
    // 動態配置記憶體
    node* n = (node*)malloc(sizeof(node));

    n->data = data;
    n->next = NULL;

    return n;
}

void insert_node(node* n1, node* n2)
{
    n2->next = n1->next;
    n1->next = n2;
}

void remove_node(node* n1)
{
    n1->next = n1->next->next;
}

void print_lists(node* lists)
{
    node* n = lists;

    // 依序印出節點內容
    while (n != NULL)
    {
        printf("%d ", n->data);

        n = n->next;
    }

    printf("\n");
}

void free_lists(node* lists)
{
    // 遞迴刪除串列所有節點
    if (lists->next != NULL)
    {
        free_lists(lists->next);
    }

    free(lists);
}
至於雙向連結串列,則是結點比單向連結串列多了一個連結指標,指向的是這個節點的前一個節點。

而環狀連結串列跟單向連結串列僅有唯一不同點,就是環狀連結串列的最後一個節點指標指向的是第一個節點。

至於這兩種連結串列的操作,基本上與單向連結串列大同小異,這裡我們不再多花篇幅解釋(格主想睡了)。
儘管連結串列在資料的新增與移除上,較陣列來的彈性許多,它也是具有許多缺點的。
除了一開始我所提到的操作麻煩之外,由於串列沒有索引值,因此要提取某節點存放的變數值會相當不方便。而且若是一個連結串列的節點相當多,每一個節點指標所佔用的記憶體也相當龐大。
因此,根據不同的情況,判斷何時用陣列、何時用串列,也是相當重要的。
5月 20, 2008
【演算】佇列 - Queue
@
| 標籤:
演算
與堆疊(stack)類似,佇列(queue)也是一種是一種同質元素集合的資料結構。與之不同的是,佇列只允許資料在後端(rear)進行插入(add)操作、在前端(front)進行刪除(delete)操作。
同樣的,讓我們舉個實例:相對於堆疊的疊盤子,你可以把佇列想像成一個正在排隊買甜甜圈的隊伍。每執行一次 "delete" 的動作就像是隊伍最前端,成功的買到甜甜圈而離開隊伍。而執行一次 "add" 就像是多了一個想買甜甜圈的客人,而在隊伍的最後端開始排隊(請忽略掉插隊問題)。
也因此,不同於堆疊的 LIFO,佇列的操作方式被稱為 FIFO (First In First Out,先入先出)。換句話說,就是越早加入佇列的人(資料)會越早離開佇列。
所以,佇列的應用範圍也相當廣泛。從剛剛舉例說明的排隊、圖形的廣度追蹤、使用印表機時的列印佇列等等,都可以見到佇列應用的蹤影。
而模擬一個佇列的運作,最簡單的方式還是使用陣列。同樣定義一個大小為 MAX_SIZE 的陣列,並使用兩個變數 front 與 rear 分別代表佇列的前後端。以下是一個簡易佇列實現的虛擬碼實例:
同樣的,陣列之外模擬方式與 C++ STL 實現的佇列相關函式這裡我們不討論,請有興趣者自行查詢相關資料。
以下是 C 使用陣列實現的原始碼,可以參考看看:
同樣的,讓我們舉個實例:相對於堆疊的疊盤子,你可以把佇列想像成一個正在排隊買甜甜圈的隊伍。每執行一次 "delete" 的動作就像是隊伍最前端,成功的買到甜甜圈而離開隊伍。而執行一次 "add" 就像是多了一個想買甜甜圈的客人,而在隊伍的最後端開始排隊(請忽略掉插隊問題)。
也因此,不同於堆疊的 LIFO,佇列的操作方式被稱為 FIFO (First In First Out,先入先出)。換句話說,就是越早加入佇列的人(資料)會越早離開佇列。
所以,佇列的應用範圍也相當廣泛。從剛剛舉例說明的排隊、圖形的廣度追蹤、使用印表機時的列印佇列等等,都可以見到佇列應用的蹤影。
而模擬一個佇列的運作,最簡單的方式還是使用陣列。同樣定義一個大小為 MAX_SIZE 的陣列,並使用兩個變數 front 與 rear 分別代表佇列的前後端。以下是一個簡易佇列實現的虛擬碼實例:
void add(Queue &queue, Type data)
{
    Index front, rear;

    if (rear = MAX_SIZE)
    {
        print("The queue is full!");
    }
    else
    {
        stack[rear] = data;
        rear = rear + 1;
    }
}

void delete(Queue &queue)
{
    Index front, rear;

    if (front = rear)
    {
        print "The queue is empty!";
    }
    else
    {
        front = front + 1;
    }
}
同樣的,陣列之外模擬方式與 C++ STL 實現的佇列相關函式這裡我們不討論,請有興趣者自行查詢相關資料。
以下是 C 使用陣列實現的原始碼,可以參考看看:
#include <stdio.h>
#include <stdlib.h>

#define MAX_SIZE 10

void addQ(int);
void deleteQ(void);

int queue[MAX_SIZE], front = 0, rear = 0;

int main(void)
{
    addQ(0);
    addQ(1);
    deleteQ();
    addQ(2);
    addQ(3);
    addQ(4);
    deleteQ();
    deleteQ();
    addQ(5);
    addQ(6);
    addQ(7);
    deleteQ();
    deleteQ();
    deleteQ();
    deleteQ();
    deleteQ();

    system("pause");
}

void addQ(int data)
{
    if (rear == MAX_SIZE)
    {
        printf("The queue is full!\n");
    }
    else
    {
        queue[rear++] = data;
    }
}

void deleteQ(void)
{
    if (front == rear)
    {
        printf("The stack is empty!\n");
    }
    else
    {
        printf("%d\n", queue[front++]);
    }
}
訂閱:
文章 (Atom)
